Habitat Engineering:AI时代,把判断力写进环境
Published:
今年初的时候, Agent 领域很流行一个词:Harness Engineering。Harness 原本是马具、缰具,也可以理解成安全带,这个比喻其实很形象:模型越来越聪明,也越来越能够自主行动,于是我们开始意识到,不能只是不断告诉它“应该怎么做”,还需要通过权限、工具、工作流、上下文、验证器和沙箱,把它真正约束在一个可以可靠工作的范围里。
但最近我越来越觉得,Harness 可能还只是这个变化的一种表现形式。如果再往前走一步,我们真正需要设计的,也许并不只是“缰绳”,而是智能体所处的整个环境。我愿意把这种更上位的工程思想称为 Habitat Engineering:它关注的不是怎样精确控制智能体的每一个动作,而是一个更大的问题——我们应该设计一个怎样的环境,让正确的事情更容易发生?
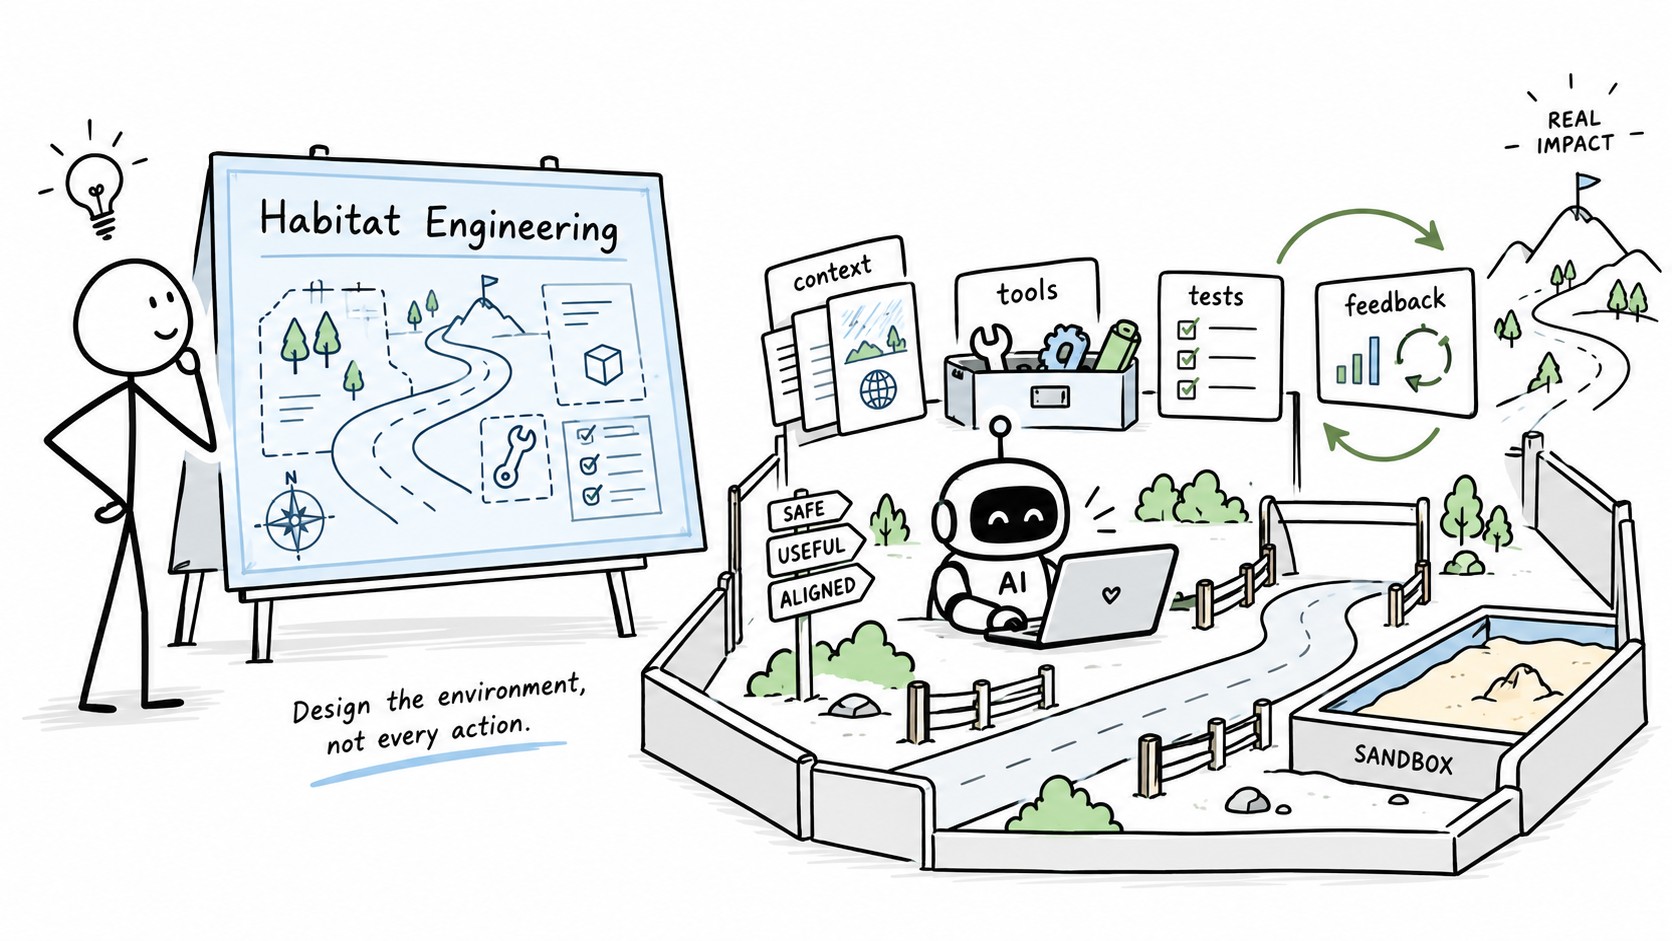
图 1:Habitat Engineering 不是控制智能体的每一步,而是设计它赖以工作的环境。
一、当“我已经说得很清楚了”不再有用
假设现在让一个 Coding Agent 开发一个普通的文件上传功能。一开始,我们可能会给它一份相当详细的需求:限制文件大小和类型,上传后返回统一的数据结构,不能直接把文件写进业务服务器,错误信息必须沿用现有错误码,还需要兼容已有的权限和存储系统。要求并不复杂,而且每一点都可以清清楚楚地写进 Prompt。
Agent 很快就把功能写完了。页面能上传,接口也能返回结果,看起来基本可用,但仔细检查却会发现各种小问题:它自己定义了一套新的错误格式,在不应该访问的目录下增加了临时文件,或者绕过项目原来的 Storage abstraction。于是我们很自然地开始补 Prompt:“必须使用现有 Storage Service”“不要直接操作文件系统”“一定要遵循原来的错误码规范”。
第二次结果可能好了一些,但新的问题又会出现。于是 Prompt 越写越长,IMPORTANT 越来越多,仓库里甚至开始出现一份专门告诉 Agent“哪些事情千万不要做”的说明文档。做到这里,我们其实仍然沿用着一种很传统的思维:只要把要求说得足够清楚,执行者最终就应该能够正确执行。
但如果某一种错误反复出现,也许真正应该修改的就不再是 Prompt,而是开发环境本身。比如,上传接口必须实现统一的 typed interface;文件操作只能通过 Storage Service;跨层依赖由 architecture lint 直接禁止;敏感目录在 sandbox 中根本不可写;错误结构由 schema 校验;功能是否完成,则由 integration test 和 end-to-end test 判断。Agent 仍然可以自由决定函数怎样拆、逻辑怎样实现,但那些我们已经确定的工程判断,不再需要它每一次重新“记住”。
这里发生了一个很重要的变化。以前我们问的是:怎样让 Agent 更好地遵守要求?现在开始问:怎样让这些要求成为环境本身的一部分?
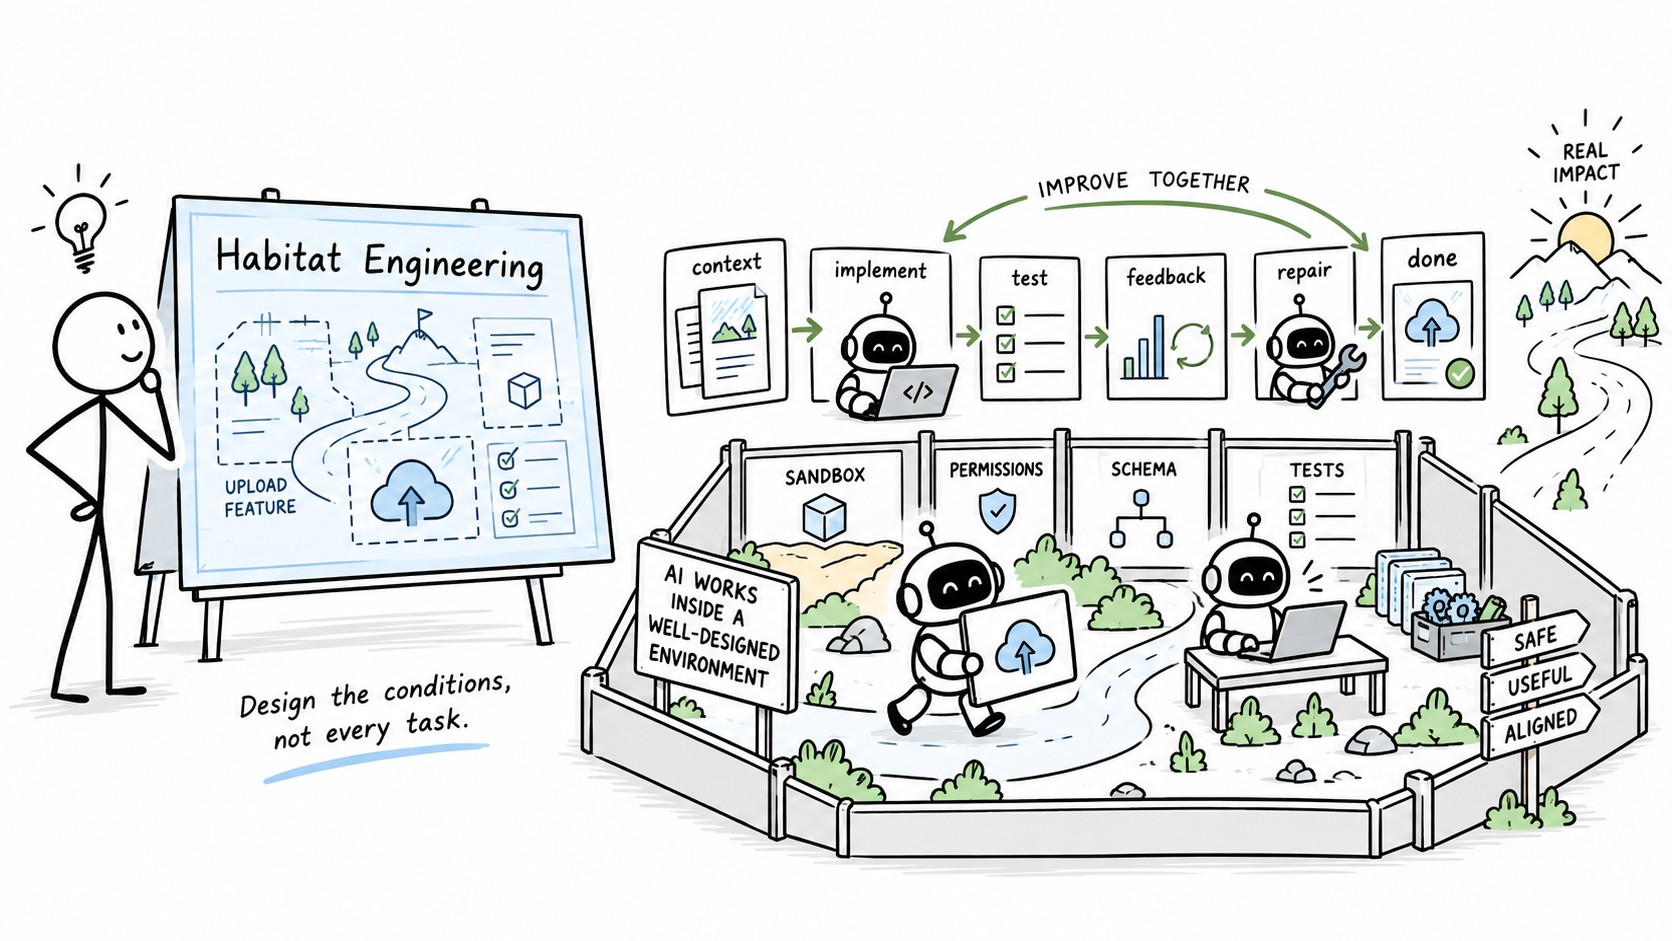
图 2:文件上传任务中的 Habitat:由上下文、权限、Schema、测试与反馈共同支撑实现—验证—修复闭环。
这也是 Harness Engineering 最近受到关注的原因之一。OpenAI 在 2026 年的一次内部实验中,从空仓库开始,让 Codex 生成应用逻辑、测试、CI、文档、可观测性和内部工具,最终形成了一个数量级达到百万行代码的产品仓库。他们把这一过程中工程师角色的变化总结为:人的主要工作不再只是写代码,而逐渐转向设计环境、表达意图和建立反馈回路,让 Agent 可以可靠地工作。1
Anthropic 对 Context Engineering 的讨论其实也指向类似的方向:问题不再只是“这一句 Prompt 应该怎么写”,而是模型在当前时刻究竟应该看到哪些信息、工具、历史和状态。在有限的 attention budget 下,更有效的做法不是不断塞入信息,而是提供尽可能少、但足够高信号的上下文。2
继续往前,就会自然出现工具、权限、状态、sandbox、verification、recovery,以及 long-running agent 中的 handoff 和 memory。这些东西看起来分别属于不同的工程模块,但从更高一层看,它们其实都在回答同一个问题:
我们究竟要给智能体设计一个怎样的世界?
这就是我理解的 Habitat Engineering。Harness 更像是在危险的位置增加安全带和护栏;Habitat 则包括道路、地图、工作台、工具、交通规则、反馈系统,以及智能体能够接触到的信息、资源和其他智能体。Harness 是 Habitat 的一种重要表现形式,而 Habitat Engineering 想讨论的是一个更大的问题:如何为一个具有自主性、但又必然存在不确定性的智能体,设计它赖以工作的环境。
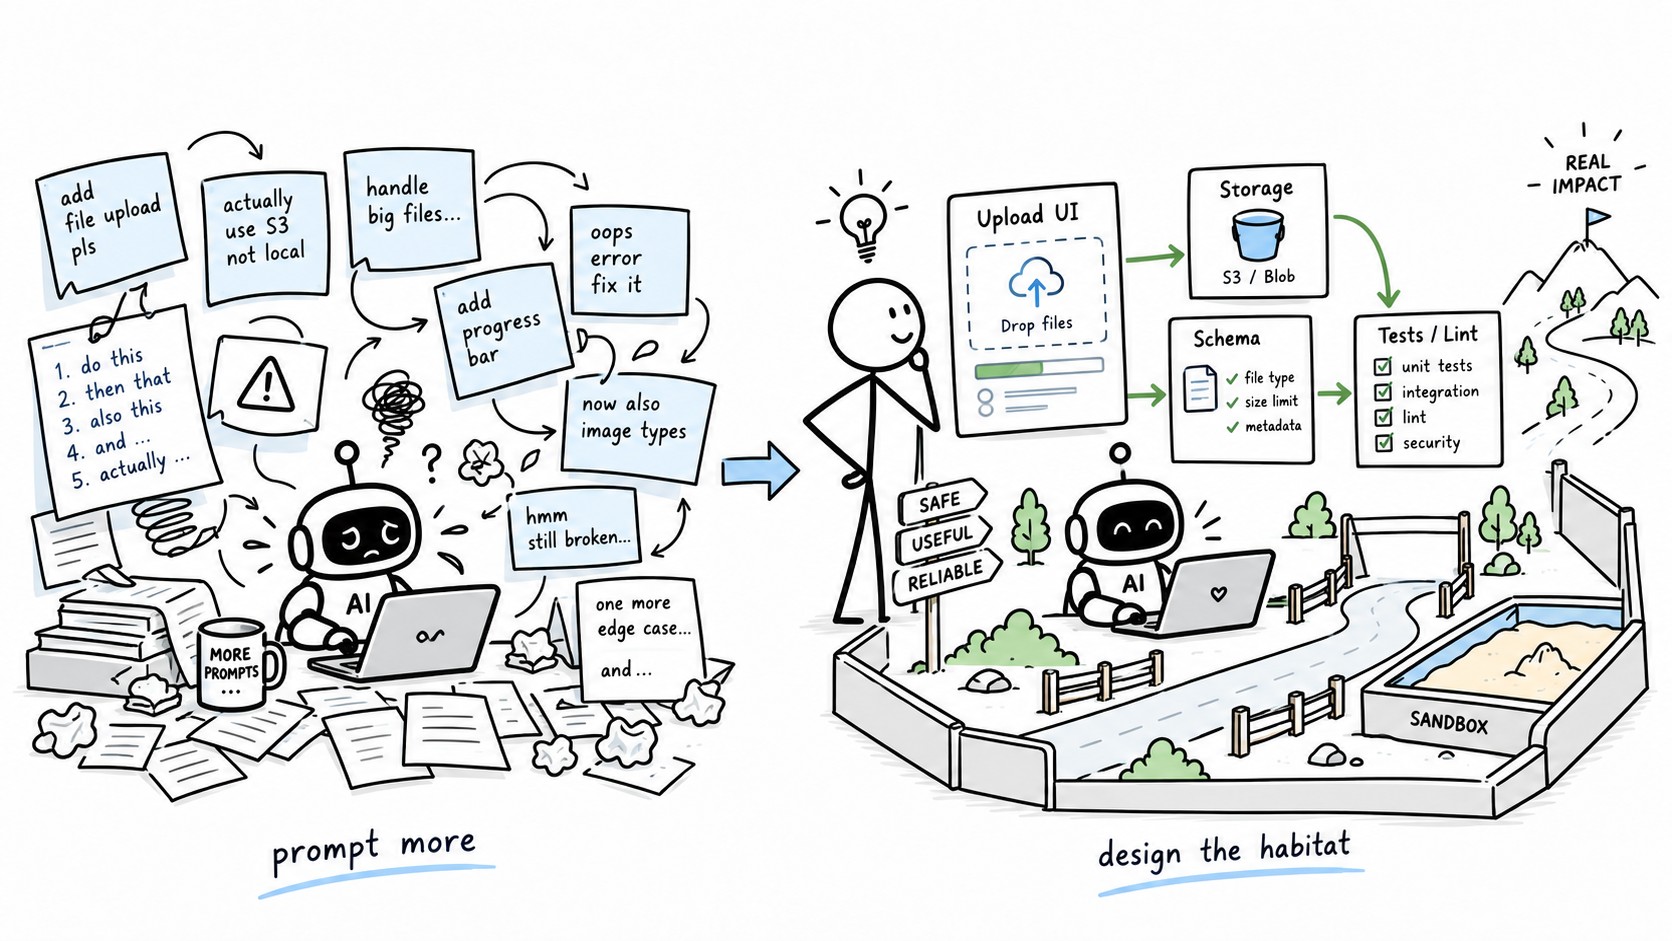
图 3:从不断追加 Prompt,转向把已经确定的工程判断写进 Habitat。
二、环境不仅约束智能,它本身就是智能的一部分
如果 Habitat Engineering 只是“给 AI 加更多限制”,那其实没有那么有意思。真正值得关注的是:环境不只是约束能力,它也在塑造能力。过去我们习惯认为,一个模型“会不会做某件事情”,主要是模型内部的能力问题;Agent 出现以后,这个边界正在越来越模糊。
SWE-agent 提出了一个很有意思的概念:Agent-Computer Interface,ACI。它把语言模型 Agent 看作一种新的计算机终端用户,并专门研究怎样重新设计 Agent 与代码库、编辑器、测试和 Shell 之间的交互方式。实验表明,即使不改变底层模型,改变接口本身也能够显著影响 Agent 浏览代码、编辑文件和运行测试的表现。3
这件事其实很重要。模型没有换,但 Habitat 变了,于是能力也变了。Anthropic 在工具设计的实践中也观察到类似现象:工具的边界、描述、参数以及返回的信息量,会直接影响 Agent 是否能正确选择并使用工具。4
假设有两个科研 Agent,背后使用完全相同的模型。第一个只能写代码、执行 Shell,然后根据 stdout 判断实验是否成功;第二个所在的环境会自动保存代码版本、数据版本、实验配置、随机种子、训练日志、完整曲线和统一 evaluator,并且任何最终结论都能够追溯到对应的实验和 evidence。它们拥有相同的“大脑”,但我们很难说它们拥有相同的科研能力。
第二个 Agent 并没有突然变聪明,它只是生活在一个更适合科研的 Habitat 里。所以我越来越觉得,可能需要重新理解所谓的“模型能力”:模型决定了智能可以达到多高,而 Habitat 决定了这些能力有多少能够真正转化成稳定、可验证的结果。
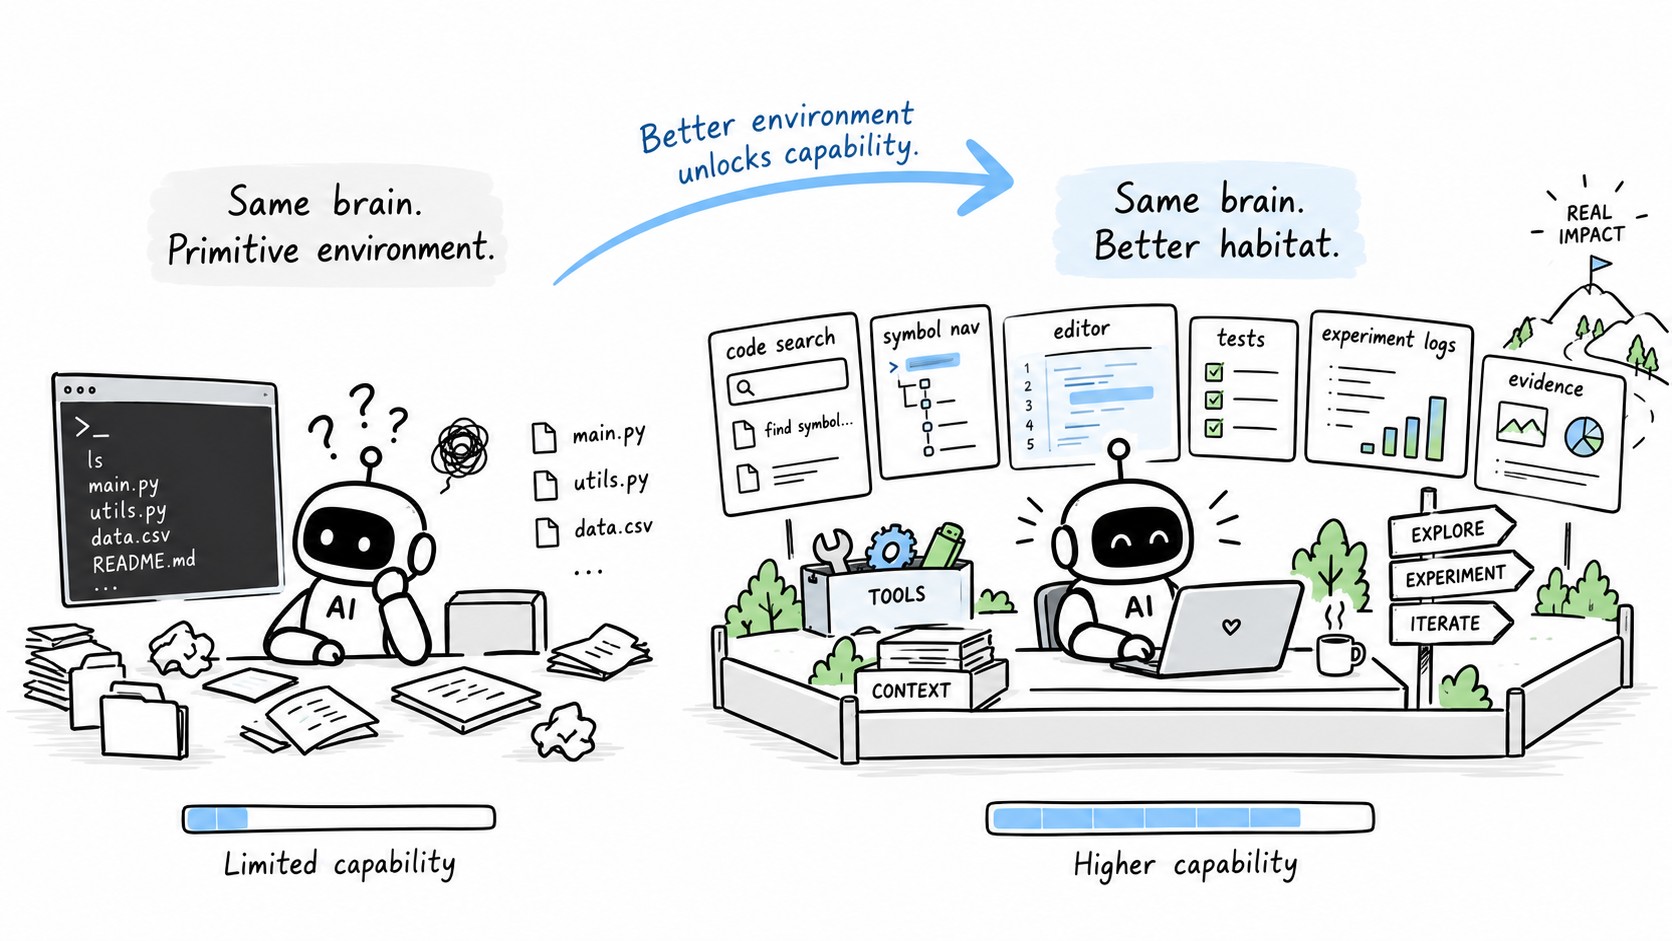
图 4:相同的模型处在不同环境中,能够转化出的稳定能力也不同。
这也意味着,很多今天被归因于“模型不够聪明”的问题,未来可能会被重新理解成 Habitat 问题。Agent 没找到答案,可能不是不会推理,而是缺少正确的信息入口;反复犯同一个错误,可能不是模型太弱,而是工具没有提供足够的反馈;长任务做不下去,也可能不是 context window 不够长,而是系统没有设计好状态、压缩和跨 session 的 handoff。Anthropic 对 long-running agent 的研究已经发现,仅靠更长的上下文并不足够,结构化的任务拆分、环境初始化和可供下一次 session 使用的持久化 artifacts 都会影响最终效果。5
而且 Habitat 也不能被设计成一套永久固定的规则。Anthropic 在后续关于 Managed Agents 的实践中直接指出,很多 harness 实际上编码了“当前模型还做不到什么”的假设;随着模型进步,这些假设可能过时,相应的 scaffolding 也应该重新审视。6
换句话说,Model 和 Habitat 本身也应该共同演化。模型更强以后,环境可以在某些地方释放更多自由;新的失败模式出现以后,又需要增加新的工具、反馈或者边界。Habitat Engineering 因而不是单纯增加规则,而是在不断回答:现在还有哪些判断需要系统保证,哪些事情已经可以重新交给智能体自己解决?
不过,不管模型多强,有一类东西我认为仍然应该尽可能留在环境里面:确定性的边界。
Intelligence can be probabilistic. Boundaries should not be.
告诉 Agent“不要读取这个目录”,是一种概率性的 steering;让它在操作系统层面根本没有权限读取,则是一条确定性的 boundary。Anthropic 在 Claude Code 的 sandbox 实践中就采用了 filesystem isolation 和 network isolation,让 Agent 在预先限定的空间内拥有更高自主权,同时从操作系统层面限制超出边界的行为。7
验证也是一样。Agent 最后说“任务已经完成”,其实不能证明什么;如果它说“机票已经预订”,真正应该检查的是数据库里面是否出现了 reservation;如果它说“代码已经修复”,应该运行测试;如果它说“实验提高了两个点”,应该检查真实的配置、运行状态和结果。Anthropic 在 Agent eval 中明确区分了 transcript 和 outcome,强调需要检查 Agent 执行以后环境的最终状态8;τ-bench 同样通过比较对话结束后的数据库状态与目标状态进行评价,并进一步使用 (pass^k) 衡量多次运行中的稳定成功率。9
所以 Habitat Engineering 关心的其实不只有 Action Space——Agent 可以做什么;还必须存在一个 Evidence Space——系统和 Agent 怎样知道刚刚到底发生了什么。只有行动能够被观察、验证和恢复,一个本来具有概率性的智能体,才有可能成为一个可靠系统的一部分。
三、当执行越来越便宜,人应该做什么?
这最终会带来一个更有意思的问题:如果 AI 越来越擅长写代码、搜索资料、生成文档、运行实验、调用工具和执行流程,那么人的价值究竟在哪里?OpenAI 在 Harness Engineering 的文章里用了一个很简洁的说法:Humans steer. Agents execute.1 我觉得这个判断基本是对的,但可能还可以再往前走一步——人未来做的可能不只是“掌舵”,而是设计智能工作的条件。
过去,一个优秀的工程师遇到问题,第一反应往往是:“这个问题我应该怎么解决?”以后,一个优秀的工程师可能会多问一句:“我应该怎样设计一个环境,让这个问题可以被 AI 持续地解决?”这看起来只是换了一个问法,但它会直接改变我们做开发、研发、算法和系统架构的方式。
比如前面的上传功能。真正成熟的做法,不是在每一次开发时重新告诉 Agent 哪些目录不能动、错误应该怎样处理、架构应该怎样遵守,而是逐渐把这些已经确定的判断变成 interface、schema、lint、test 和 permission。下一次再实现下载、预览或者文件解析时,这些经验不需要从头解释,因为它们已经成为 Habitat 本身的一部分。
算法研发也是一样。以前模型结果下降,我们很容易马上换模型、换 loss、调 Prompt;以后第一步也许应该先问,失败究竟来自 model、data、context、tool、workflow,还是 evaluator。安全也一样,与其反复告诉 Agent“千万不要泄露密钥”,更可靠的办法是让真正的密钥根本不进入它可以访问的环境。
这些事情表面看起来分别属于产品、算法、软件工程、DevOps、安全和人机交互,但背后其实是同一种工程思想:
不要把正确寄托在执行者每一次都做出最佳判断,而是把已经确定的判断尽可能写进环境。
我觉得这可能会成为 AI 时代工程师一个很重要的角色变化。过去工程师最重要的产物往往是自己完成的代码、模型、实验和系统;以后越来越重要的产物,也许会变成一个能够持续产生可靠结果的 Habitat。人的工作因此会逐渐从 Execution 向上移动:什么值得做,什么才算正确,哪些地方应该给予 AI 自由,哪些地方必须存在确定性边界,什么证据足够宣布完成,以及哪些失败值得沉淀成新的测试、工具或者机制。
然后,人把一次次自己的判断重新写回 Habitat。
这也是为什么我觉得 Habitat Engineering 不只是一个新的 Agent Engineering 术语,它更像一种新的工程思想。甚至再往外看一步,人其实一直在给自己设计 Habitat:投资时提前规定仓位和止损规则,工作中设置审批和复核,软件开发中设置 CI,生活中关闭容易让自己分心的通知。这些事情背后的共同前提,就是承认执行者并不永远处在最佳状态。
所以 AI 带给我们的一个有意思的变化,并不只是模型越来越聪明。它迫使我们重新学习一件其实非常古老的事情:不要试图通过反复教育一个不稳定的执行者获得稳定结果。真正成熟的工程,会把经验变成规则,把规则变成机制,再把机制变成环境。
Prompt Engineering 在思考:我们应该告诉 AI 什么?
Context Engineering 开始思考:AI 此刻应该知道什么?
Harness Engineering 进一步思考:我们怎样让 AI 更稳定地行动?
而 Habitat Engineering 想继续追问:
我们应该为越来越强的智能,设计一个怎样的世界?
它不是为了控制智能的每一步。恰恰相反,好的 Habitat 应该在边界内部给予智能足够的自由,同时把那些已经确定的原则留给环境:让智能负责探索,让系统负责确定性;让错误可以发生,但不能悄无声息地发生;让失败可以出现,但必须能够被发现、理解和恢复。
最终,人的判断不再只存在于某一次 Prompt、某一份文档或者某一个人的脑子里,而是逐渐成为环境本身的一部分。
一个最小的 Habitat Engineering 样例
再回到最开始的文件上传功能。如果按照传统的 Prompt-first 思路,我们可能会写一页需求,再附上十几条“千万不要”的注意事项,然后让 Agent 开始工作。Habitat-first 的思路则不同:在 Agent 开始写第一行代码之前,先设计好它工作的世界。
可以只有五件事:
- Context:只提供相关模块、现有 Storage interface、API schema、相邻功能和 architecture rules,而不是把整个仓库一次性塞进上下文。
- Action Space:Agent 可以自由修改上传模块和测试,但敏感数据目录只读;所有存储操作必须经过统一的 Storage interface。
- Deterministic Boundaries:类型、跨层依赖、API schema、安全规则由 compiler、lint、policy 和 sandbox 强制执行,而不是写在 Prompt 里期待 Agent 记住。
- Evidence & Feedback:每次修改以后自动执行 unit test、integration test、type check 和必要的端到端测试,把失败日志重新反馈给 Agent。
- Completion & Recovery:只有所有验收条件通过才能宣布完成;修改、日志、测试结果和失败状态都被保存,因此出错以后可以定位、回滚并继续修复。
这时候 Agent 的工作循环就变成了:
理解局部环境 → 自主实现 → 系统验证 → 获取反馈 → 自主修复 → 再次验证。
人的工作则主要集中在开始之前和失败之后:定义什么叫完成,决定哪些边界不可突破,并观察重复出现的失败是否意味着 Habitat 还缺少某一种机制。下一次再开发类似功能时,我们不需要重新提醒 Agent 那十几条规则,因为上一次获得的工程判断已经被沉淀进了环境。
这可能就是 Habitat Engineering 最简单的样子。
它不是给 Agent 写一个更长的 Prompt,而是不断减少那些本来就不应该依赖 Prompt 的事情。
也许 AI 时代真正重要的新工程,不再只是制造越来越聪明的大脑,而是学习如何为越来越强的智能,设计它们所生活的世界。
References
R. Lopopolo, “Harness engineering: leveraging Codex in an agent-first world,” OpenAI, Feb. 11, 2026. [Online]. Available: OpenAI Engineering. ↩ ↩2
Anthropic, “Effective context engineering for AI agents,” Sep. 29, 2025. [Online]. Available: Anthropic Engineering. ↩
J. Yang, C. E. Jimenez, A. Wettig, K. Lieret, S. Yao, K. Narasimhan, and O. Press, “SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering,” in Advances in Neural Information Processing Systems, vol. 37, 2024. ↩
Anthropic, “Writing effective tools for AI agents—using AI agents,” Sep. 11, 2025. [Online]. Available: Anthropic Engineering. ↩
Anthropic, “Effective harnesses for long-running agents,” Nov. 26, 2025. [Online]. Available: Anthropic Engineering. ↩
Anthropic, “Scaling Managed Agents: Decoupling the brain from the hands,” Apr. 8, 2026. [Online]. Available: Anthropic Engineering. ↩
Anthropic, “Beyond permission prompts: Making Claude Code more secure and autonomous,” Oct. 20, 2025. [Online]. Available: Anthropic Engineering. ↩
Anthropic, “Demystifying evals for AI agents,” Jan. 9, 2026. [Online]. Available: Anthropic Engineering. ↩
S. Yao, N. Shinn, P. Razavi, and K. Narasimhan, “(\tau)-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains,” in Proc. International Conference on Learning Representations (ICLR), 2025. ↩